En la era digital actual, los datos se han convertido en el activo más valioso para las empresas de todos los tamaños y sectores. Sin embargo, la gestión, almacenamiento y análisis eficientes de grandes volúmenes de datos representan un desafío considerable. Es aquí donde entra en juego el concepto de Data Lake, una solución innovadora que promete cambiar la forma en que las organizaciones manejan su información. Según las previsiones de Statista, el volumen de datos generados en todo el mundo superará los 180 zetabytes en 2025, lo que supone un crecimiento medio anual de casi el 40% en cinco años.
¿Qué es un Data Lake?
Un Data Lake es una plataforma de almacenamiento centralizada que permite a las empresas recolectar, almacenar y procesar grandes cantidades de datos de diferentes fuentes y formatos. A diferencia de los sistemas tradicionales de almacenamiento de datos, los Data Lakes no requieren una estructura previa o un esquema rígido. En cambio, actúan como un vasto repositorio en el que los datos pueden ser almacenados en su forma original, lo que brinda flexibilidad y escalabilidad sin precedentes.
Beneficios de un Data Lake
- Almacenamiento sin estructura: Los Data Lakes permiten capturar y almacenar datos de diversas fuentes sin la necesidad de una transformación previa, lo que facilita la ingesta de datos rápidamente y ahorra tiempo en la preparación y limpieza de datos.
- Flexibilidad analítica: Al tener los datos en su estado bruto, los Data Lakes brindan a los analistas y científicos de datos la libertad de explorar, analizar y descubrir información valiosa sin restricciones. Esto fomenta la innovación y el descubrimiento de conocimientos ocultos.
- Escalabilidad: Los Data Lakes están diseñados para manejar grandes volúmenes de datos, lo que los convierte en una solución escalable que puede crecer con las necesidades de la empresa a medida que sus datos se expanden.
- Integración de datos: Al centralizar los datos en un Data Lake, se crea un punto único de acceso para todas las fuentes de información de la empresa, lo que facilita la integración y la colaboración entre equipos y departamentos.
- Análisis en tiempo real: Los Data Lakes pueden admitir análisis en tiempo real, lo que permite a las organizaciones tomar decisiones más rápidas y basadas en datos actualizados, lo que conduce a una ventaja competitiva significativa.
Cuáles son las principales diferencias entre Data Lake y Dara Warehouse
El Data Lake y el Data Warehouse son dos enfoques diferentes para almacenar y gestionar datos. A continuación, se presentan las principales diferencias entre ellos:
Estructura de los datos
En un Data Lake, los datos se almacenan en su forma original, sin estructura y sin transformación previa. Esto significa que los datos se guardan tal como se capturaron, sin imponer un esquema o formato específico. Esto permite una mayor flexibilidad para explorar y analizar los datos en diferentes formatos, como texto sin procesar, archivos multimedia, datos de sensores, entre otros.
En un Data Warehouse, los datos se estructuran y transforman previamente antes de ser almacenados. Se aplica un esquema fijo y consistente a los datos, lo que implica que se realiza un proceso de extracción, transformación y carga (ETL) para adaptar los datos a un formato específico. Los datos se organizan en tablas y columnas según el esquema definido.
Tipo de datos
Un Data Lake es adecuado para almacenar y procesar una amplia variedad de datos, tanto estructurados como no estructurados. Puede contener datos sin procesar, datos en tiempo real, registros de eventos, archivos de registro, datos de redes sociales, datos de sensores, entre otros.
Un Data Warehouse se enfoca principalmente en datos estructurados, como datos transaccionales, datos financieros, datos de ventas, entre otros. Está diseñado para almacenar datos de alta calidad y bien definidos que se utilizan en análisis empresariales y en la generación de informes.
Escalabilidad y costo
Los Data Lakes son altamente escalables, lo que significa que pueden manejar grandes volúmenes de datos de manera eficiente. Además, los Data Lakes pueden aprovechar tecnologías de almacenamiento y procesamiento distribuido, como el almacenamiento en la nube y el procesamiento en clústeres, lo que permite una escalabilidad horizontal a medida que los requisitos de almacenamiento y procesamiento aumentan. En términos de costo, los Data Lakes pueden ser más económicos en comparación con los Data Warehouses, ya que no requieren la estructuración y transformación previa de los datos.
Los Data Warehouses también pueden ser escalables, pero generalmente están diseñados para manejar volúmenes de datos más limitados. La escalabilidad vertical (aumento de capacidad en un servidor) es común en los Data Warehouses. Sin embargo, el costo asociado con los Data Warehouses puede ser más alto, ya que requieren una infraestructura específica y el proceso de ETL puede ser complejo y costoso.
Análisis y consultas
Un Data Lake permite un análisis más exploratorio y flexible de los datos, ya que los datos se almacenan en su forma original y se pueden procesar utilizando tecnologías de Big Data como Hadoop, Spark, y herramientas de análisis avanzado. Sin embargo, la preparación y transformación de datos puede requerir más tiempo y esfuerzo.
Un Data Warehouse está optimizado para consultas y análisis predefinidos. Los datos se estructuran de manera que las consultas y los informes puedan ejecutarse de manera eficiente y rápida.
Si quieres saber más sobre Data Warehouse, nuestro profesor y Head of Data en VMLY&R Spain, Álvaro Montero, explica brevemente qué es y cómo utilizarlo en este vídeo:
Características clave de un Data Lake Inteligente
- Descubrimiento y catalogación automática: Un Data Lake inteligente utiliza técnicas de IA y ML para descubrir y catalogar automáticamente los datos. Esto incluye la identificación de tipos de datos, el etiquetado semántico y el establecimiento de relaciones entre los diferentes conjuntos de datos. Esto facilita la búsqueda y recuperación de datos relevantes.
- Análisis avanzado: La combinación de un Data Lake con capacidades de IA y ML permite realizar análisis avanzados en los datos. Se pueden aplicar algoritmos de aprendizaje automático para descubrir patrones, tendencias y correlaciones ocultas en los datos. Esto brinda a las organizaciones una ventaja competitiva al obtener conocimientos más profundos y precisos.
- Automatización de procesos: Un Data Lake inteligente puede automatizar diversos procesos relacionados con la gestión de datos. Esto incluye la detección y corrección de datos duplicados o inconsistentes, la limpieza y enriquecimiento automático de datos, y la generación automatizada de informes y visualizaciones.
- Seguridad y gobernanza: La seguridad y la gobernanza de los datos son aspectos críticos en cualquier entorno de datos. Un Data Lake inteligente implementa medidas de seguridad avanzadas, como el cifrado de datos, el control de acceso basado en roles y la supervisión de actividades. Además, proporciona capacidades de gobernanza de datos para garantizar el cumplimiento de regulaciones y políticas internas.
En esencia, un Data Lake es una herramienta revolucionaria que puede transformar la forma en que las empresas gestionan y utilizan sus datos. Desde su almacenamiento sin estructura hasta su flexibilidad analítica y escalabilidad, los Data Lakes ofrecen numerosos beneficios que pueden impulsar la toma de decisiones informadas y la innovación empresarial.
Desde MIOTI Tech & Business School estamos siempre a la vanguardia tecnológica por eso actualizamos constantemente nuestro programas, como nuestro Máster en Data & Cloud Engineering o nuestro Máster en Data Science & Big Data.
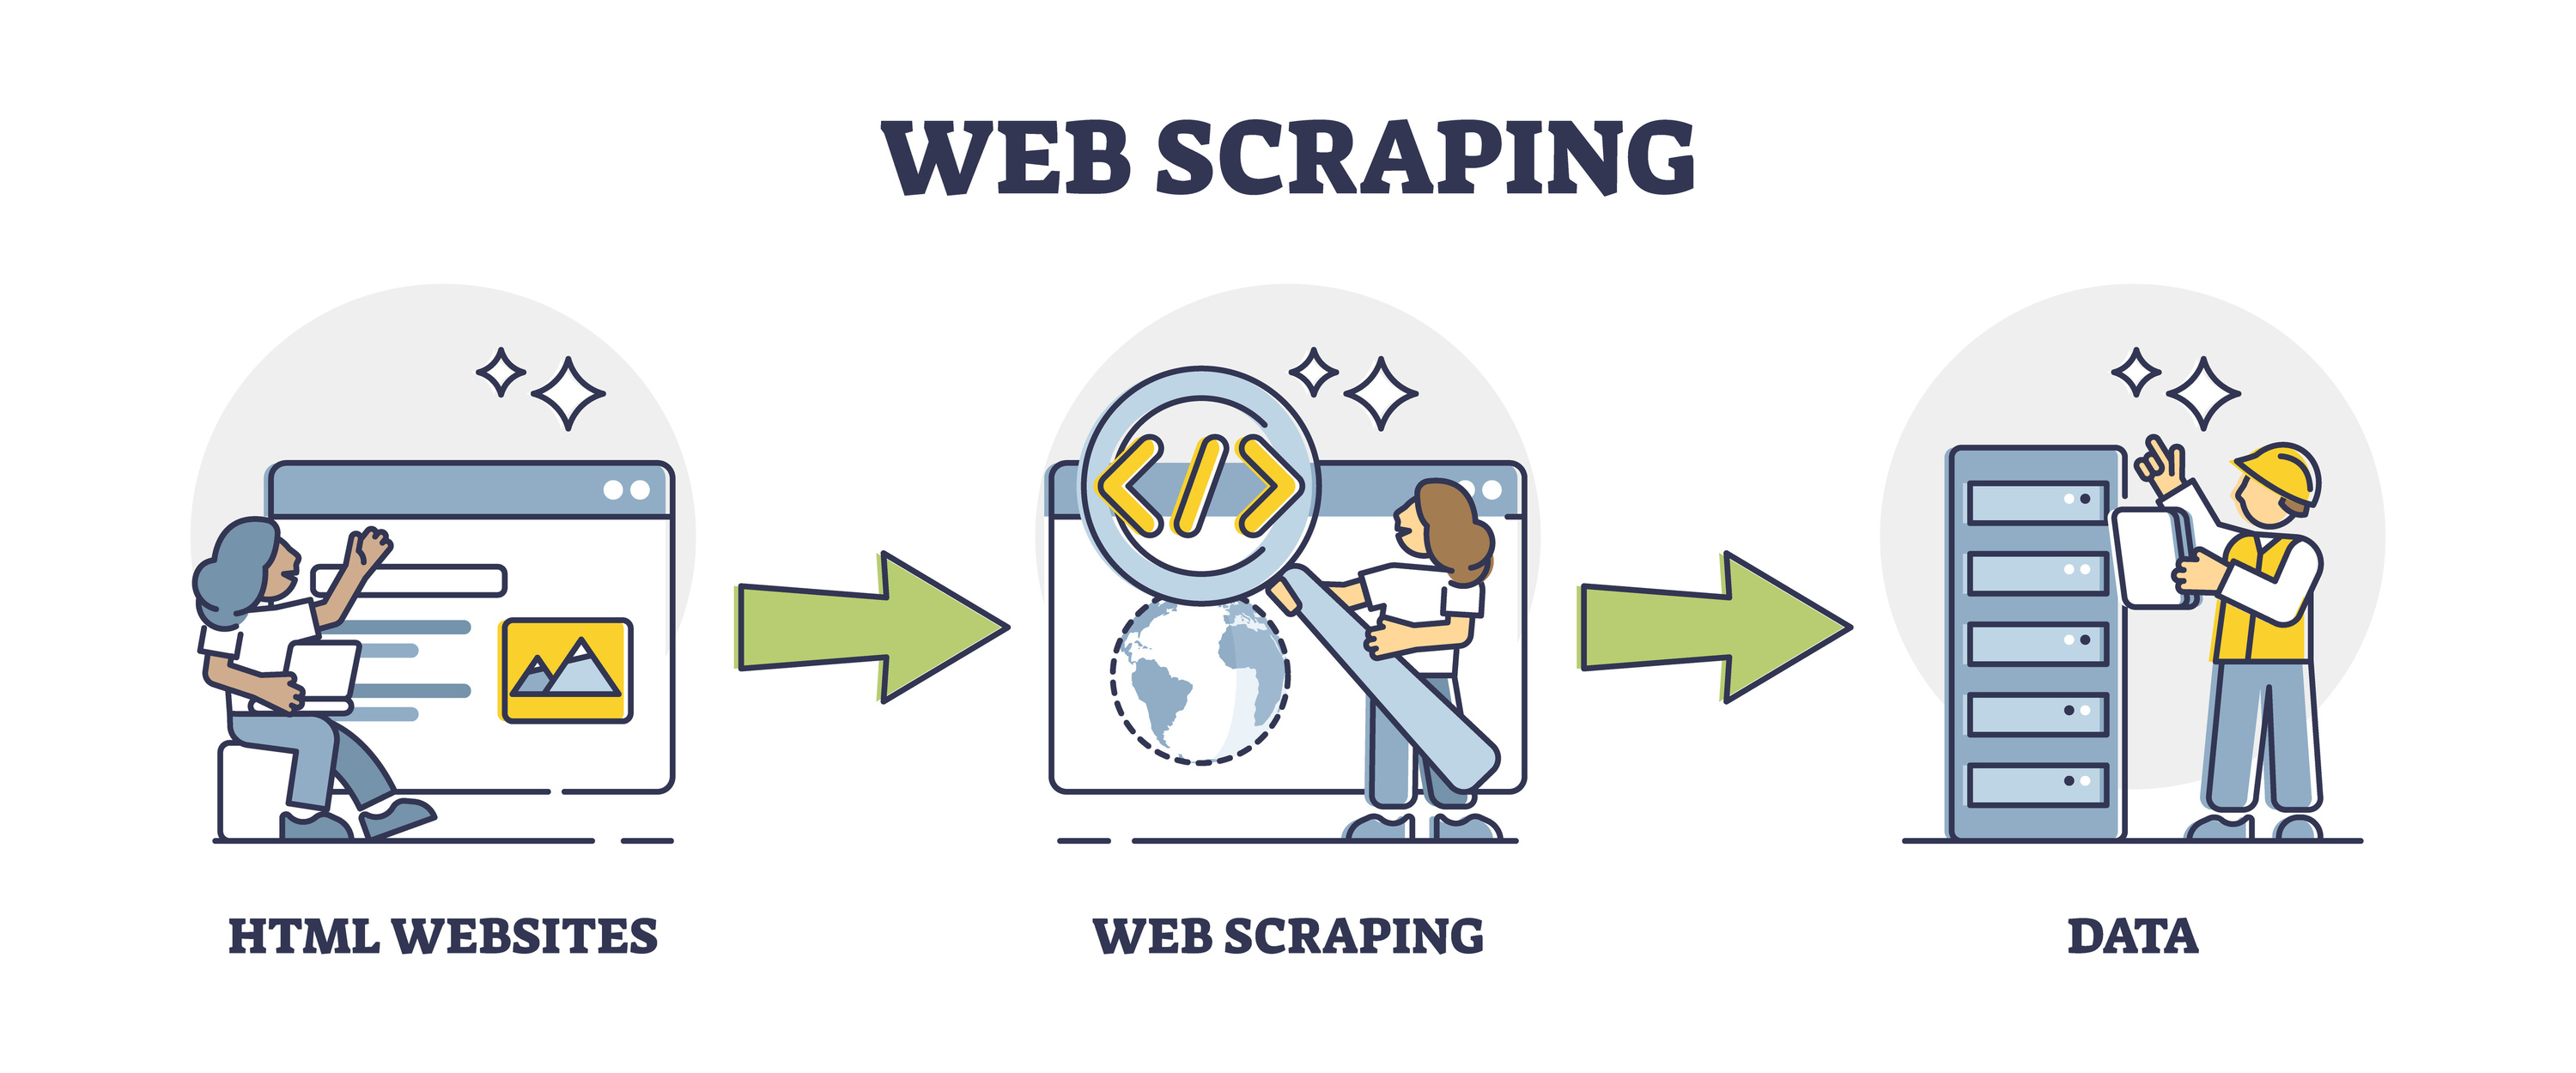
¿Qué es el Web Scraping?
En la era de la información, acceder a datos precisos y actualizados es fundamental para tomar decisiones estratégicas en el ámbito empresarial. Es aquí donde el Web Scraping, una técnica avanzada de extracción de datos, se presenta como una poderosa herramienta para obtener información relevante de fuentes en línea de manera automatizada.
El Web Scraping, también conocido como web data mining, implica la extracción sistemática y estructurada de datos de páginas web mediante el uso de algoritmos y scripts personalizados. Esta técnica permite obtener información como precios de productos, reseñas de clientes, datos de competidores y más, para analizar y aprovechar en la toma de decisiones empresariales.
Al automatizar el proceso de recopilación de datos, el Web Scraping ahorra tiempo valioso y mejora la eficiencia en la obtención de información. Además, al proporcionar datos actualizados en tiempo real, esta técnica permite una visión más precisa y actualizada del mercado, lo que es fundamental para adaptarse rápidamente a las demandas y tendencias cambiantes.
No obstante, es fundamental respetar los términos de uso y las políticas de privacidad establecidos por los sitios web que se desean extraer. Una práctica ética y responsable del Web Scraping es esencial para mantener la integridad y la reputación tanto de la organización como de los datos recopilados.
Las principales librerías de Python para Web Scraping
Estas son solo algunas de las principales librerías de Python para Web Scraping. Cada una tiene sus propias fortalezas y se adapta a diferentes necesidades y casos de uso.
1. Beautiful Soup
Como una de las librerías más populares para Web Scraping, Beautiful Soup facilita el análisis y extracción de datos de documentos HTML y XML. Con una sintaxis amigable y poderosas funcionalidades, te permite navegar por la estructura del código fuente de una página web y extraer los elementos deseados de manera intuitiva.
2. Scrapy
Si estás buscando una solución más completa para proyectos de Web Scraping a gran escala, Scrapy es la elección perfecta. Esta librería de alto rendimiento y código abierto te brinda un amplio conjunto de herramientas para extraer datos estructurados de manera eficiente. Scrapy cuenta con un sistema de gestión de peticiones, permite la programación de spiders personalizados y facilita el almacenamiento y procesamiento de datos obtenidos.
3. Selenium
A diferencia de las librerías anteriores, Selenium está diseñada específicamente para la automatización de navegadores web. Es ideal cuando el contenido de un sitio web se genera dinámicamente mediante Java Script u otras tecnologías interactivas. Con Selenium, puedes simular acciones de navegación, completar formularios, hacer clic en elementos y extraer datos de manera programática.
4. Requests
Aunque no es una librería de Web Scraping en sí misma, Requests es una herramienta esencial para realizar solicitudes HTTP en Python. Con una sintaxis simple y elegante, permite enviar y recibir datos a través de solicitudes GET y POST. Requests es comúnmente utilizada en combinación con BeautifulSoup u otras librerías para descargar y analizar el contenido de una página web.
5. PyQuery
Si estás familiarizado con jQuery, te encantará PyQuery. Esta librería te permite usar selectores CSS y manipular documentos HTML de manera similar a como lo harías en jQuery. PyQuery facilita la extracción y manipulación de elementos HTML específicos, lo que la convierte en una opción conveniente para tareas de Web Scraping más simples.
Ejemplos de Web Scraping
Estos son solo algunos ejemplos de cómo se puede aplicar el Web Scraping en diferentes áreas:
- Extracción de precios y datos de productos: Las empresas de comercio electrónico pueden utilizar el Web Scraping para extraer información de precios y detalles de productos de diferentes sitios web. Esto les permite realizar análisis comparativos, ajustar sus estrategias de precios y mantenerse competitivos en el mercado.
- Monitorización de opiniones y reseñas: Las empresas pueden utilizar el Web Scraping para recopilar opiniones y reseñas de productos o servicios de múltiples sitios web y plataformas. Esto les permite obtener una visión general de la percepción del cliente, identificar patrones y tendencias, y ajustar sus estrategias de marketing y desarrollo de productos.
- Recopilación de datos para investigación académica: Los investigadores académicos pueden utilizar el Web Scraping para recopilar datos relevantes de sitios web, como estudios científicos, noticias, información demográfica, entre otros. Esto les permite obtener grandes volúmenes de datos para su análisis y estudio.
- Análisis de mercado y seguimiento de la competencia: Las empresas pueden utilizar el Web Scraping para monitorear y recopilar datos sobre la actividad de sus competidores, como precios de productos, promociones, estrategias de marketing y más. Esto les permite tomar decisiones informadas y ajustar su enfoque comercial.
- Extracción de datos de redes sociales: El Web Scraping se utiliza para extraer datos de plataformas de redes sociales, como Twitter o Instagram, para analizar tendencias, recopilar datos demográficos, realizar estudios de opinión pública, entre otros fines.
En MIOTI contamos con programas actualizados en la vanguardia tecnológica para dar la mejor formación tecnológica, como nuestro Máster en Data Science y Big Data.
El Real Betis se coronó como el club más eficiente en la emocionante final de la eLaLiga Santander celebrada en el estadio Cívitas Metropolitano. El equipo, que recibió el trofeo de manos de Fabiola Pérez, CEO y Co-fundadora de MIOTI Tech & Business School, no fue el único logro que consiguieron, ya que también se consagraron campeones de la sexta edición del campeonato.
El objetivo principal de nuestro patrocinio en eLaLiga Santander, junto a otras grandes empresas como PlayStation o Santander, es fomentar nuevas vocaciones tecnológicas entre los jóvenes a través de los eSports y maximizar las oportunidades laborales en el ámbito digital.
Los jugadores ganan partidos, los datos campeonatos
Una de las contribuciones clave de MIOTI a lo largo de la competición ha sido proporcionar estadísticas detalladas sobre los equipos antes y después de los partidos. Estos datos han incluido información sobre victorias, empates, derrotas, así como goles a favor y en contra. Gracias a esta información de valor, los equipos han podido analizar su desempeño y tomar decisiones estratégicas para mejorar su rendimiento en los partidos disputados.
El Real Betis con Matías Bonanno y Alejandro Hidalgo a la cabeza ha demostrado ser un equipo excepcional durante toda la temporada, y su actuación impecable les ha llevado a levantar el título de campeones. En la final, Bonanno se enfrentó al jugador del RC Celta JRA imponiéndose por 5 goles a 4 en la final. Por ello, fue este joven jugador quien tuvo el honor de alzarse con el trofeo en representación del Betis, destacando el impresionante coeficiente de goles marcados y encajados del equipo a lo largo de la competición. En este vídeo podéis ver un resumen de lo qué ocurrió durante la jornada de la Final de eLaLiga Santander:
El Betis ha anotado un total de 78 goles a lo largo de la temporada, mientras que solo ha recibido 42 goles en contra. Además, han logrado 11 victorias, 5 empates y apenas 1 derrota. Estas impresionantes cifras reflejan la efectividad y precisión del equipo en cada encuentro. Con un 91% de pases completados con éxito y 94 tiros a puerta de los 129 efectuados, el Betis ha demostrado una gran habilidad técnica y una estrategia bien definida.
Los equipos de Data Science, cada vez más importantes en los clubes de fútbol
Nuestra CEO y Co-fundadora, Fabiola Pérez, se ha mostrado muy entusiasmada por patrocinar un evento de la magnitud de eLaLiga Santander. “Los eSports son una forma de llegar a las nuevas generaciones y maximizar las oportunidades laborales de los perfiles digitales. Es por ello que los mejores clubs de fútbol están incorporando equipos especializados en Data Science para desarrollar estrategias ganadoras, y en la versión virtual de los partidos, los datos juegan un papel fundamental para alcanzar la victoria. El Real Betis ha sido un ejemplo muy claro de cómo un uso inteligente y digital de los datos puede llevar al éxito en esta competición”, ha subrayado.
Además de promover el mundo de los eSports y el análisis de datos, MIOTI tiene como objetivo reducir la brecha digital en España. La colaboración con eLaLiga Santander es un paso importante para motivar a los jóvenes a adentrarse en el campo de la tecnología y abrirles las puertas a un futuro prometedor en el ecosistema tech.
El éxito del Real Betis en la eLaLiga Santander demuestra el impacto positivo que puede tener el análisis de datos en los eSports. Los equipos que comprenden su importancia y utilizan estrategias basadas en ellos pueden lograr un rendimiento sobresaliente. El Betis ha sido un claro ejemplo de cómo el enfoque tecnológico puede llevar al triunfo y ha dejado una huella imborrable en la historia de la competición.
Desde MIOTI Tech & Business School continuamos apostando por la promoción de las vocaciones tecnológicas y la aplicación de la ciencia de datos en diferentes ámbitos, incluido el deporte electrónico, con programas especializados en la materia, como nuestro Máster en Data Science y Analytics.
¿Qué es el Data Engineering?
El Data Engineering (Ingeniería de Datos, en español) es una disciplina de la ciencia de datos que se enfoca en el diseño, construcción, implementación y mantenimiento de sistemas y arquitecturas de datos para manejar grandes cantidades de información.
En otras palabras, el Data Engineering se encarga de crear infraestructuras de datos que permitan almacenar, procesar y acceder a grandes volúmenes de información de manera eficiente y escalable. Los ingenieros de datos trabajan con diversas fuentes de datos, como bases de datos, archivos, sistemas de mensajería, dispositivos IoT, entre otros, para construir pipelines de datos que permitan la extracción, transformación y carga de datos hacia sistemas de almacenamiento centralizados como almacenes de datos, data lakes o sistemas de big data.
¿Por qué es importante?
El Data Engineering es una disciplina fundamental para la ciencia de datos y el análisis de datos, ya que proporciona la infraestructura necesaria para que los científicos de datos puedan analizar y visualizar los datos de manera eficiente. Además, también es importante para el desarrollo de aplicaciones de inteligencia artificial y aprendizaje automático, ya que estos sistemas requieren grandes cantidades de datos para entrenarse y mejorar su precisión.
De hecho, es uno de los 25 empleos más demandados según el estudio ‘Empleos en Auge 2023‘ que elabora cada año LinkedIn, del que ya hemos hablado con anterioridad en este post de blog.
Aplicaciones del Data Engineering
El Data Engineering es una disciplina fundamental y con un enorme potencial para cambiar y transformar muchas industrias tanto en el presente como en el futuro. A continuación, detallamos algunas de las aplicaciones más importantes del Data Engineering.
Análisis de datos en tiempo real
Con el creciente volumen de datos generados por sensores IoT y dispositivos móviles, la necesidad de procesar datos en tiempo real se ha vuelto cada vez más crítica. El Data Engineering proporciona soluciones para la captura y procesamiento de datos en tiempo real, lo que permite a las organizaciones tomar decisiones en tiempo real y detectar patrones y tendencias que de otra manera serían difíciles de identificar.
Por ejemplo, una empresa de servicios financieros puede utilizar el Data Engineering para capturar y procesar transacciones en tiempo real y detectar patrones sospechosos de fraude. De esta manera, pueden tomar medidas preventivas y minimizar el impacto de posibles ataques bancarios.
Almacenamiento y procesamiento de grandes volúmenes de datos
Las organizaciones generan ingentes volúmenes de datos a diario y necesitan almacenarlos de manera eficiente para un acceso y análisis fáciles. El Data Engineering proporciona soluciones para el almacenamiento y procesamiento de estas enormes cantidades de información, lo que permite a las organizaciones almacenar datos de diversas fuentes y formatos en una única plataforma y realizar análisis de manera más eficiente.
Un ejemplo de esto es la industria del marketing digital, donde las empresas utilizan el Data Engineering para almacenar grandes volúmenes de datos de clientes y realizar análisis de su comportamiento para optimizar las campañas de publicidad y mejorar la experiencia del usuario.
Integración de datos de diversas fuentes
En muchas organizaciones, los datos provienen de diversas fuentes y formatos, lo que dificulta su integración y análisis. El Data Engineering proporciona soluciones para integrar datos heterogéneos en una única plataforma, lo que facilita el análisis y la toma de decisiones.
Por ejemplo, una empresa de manufactura puede utilizar el Data Engineering para integrar datos de sensores de máquinas, datos de inventario y datos de proveedores, lo que les permite tener una visión holística de sus operaciones y tomar decisiones informadas para mejorar la eficiencia y reducir los costes.
Machine Learning e Inteligencia Artificial
Los modelos de Machine Learning e Inteligencia Artificial requieren grandes volúmenes de datos para su entrenamiento y validación. El Data Engineering proporciona soluciones para su almacenamiento y procesamiento, lo que impulsa la implementación de soluciones basadas en IA y ML.
Un ejemplo de esto es el sector salud, donde las empresas utilizan el Data Engineering para almacenar y procesar grandes volúmenes de datos de pacientes y entrenar modelos de IA para el diagnóstico y tratamiento de enfermedades.
Análisis de datos históricos
El análisis de datos históricos es una práctica común en la ciencia de datos y permite a las organizaciones identificar patrones y tendencias a lo largo del tiempo. El Data Engineering proporciona soluciones para el almacenamiento y procesamiento de datos históricos, lo que permite a las organizaciones realizar análisis más profundos y obtener información valiosa para la toma de decisiones estratégicas.
Por ejemplo, una empresa de comercio electrónico puede utilizar el Data Engineering para almacenar y procesar datos históricos de transacciones, perfiles de clientes y comportamientos de compra. Con estos datos, pueden identificar hábitos de compra, segmentar a sus clientes y personalizar ofertas y recomendaciones, lo que mejora la experiencia del cliente y aumenta las ventas.
Optimización de procesos y eficiencia operativa
El Data Engineering también se utiliza para optimizar procesos y mejorar la eficiencia operativa en diversas industrias. Al capturar y procesar datos en tiempo real, las organizaciones pueden monitorizar y analizar el rendimiento de sus procesos y tomar medidas correctivas en el momento oportuno y necesario.
Por ejemplo, una compañía de logística puede utilizar el Data Engineering para capturar datos en tiempo real de su flota de vehículos, rutas de entrega y condiciones del tráfico. Esto les permite optimizar los itinerarios de reparto, reducir los tiempos de espera y mejorar la eficiencia general de sus operaciones.
Personalización y mejora de la experiencia del cliente
El Data Engineering desempeña un papel fundamental en la personalización y mejora de la experiencia del cliente. Al integrar y analizar datos de múltiples fuentes, las organizaciones pueden comprender mejor las preferencias y necesidades de sus clientes y ofrecerles productos y servicios personalizados.
Un ejemplo de esto es la industria minorista, donde las empresas utilizan el Data Engineering para capturar y analizar datos de compras, historial de navegación y comentarios de los clientes. Con esta información, pueden ofrecer recomendaciones personalizadas, promociones dirigidas y mejorar la experiencia de compra en general.
El Data Engineering, por tanto, tiene una amplia gama de aplicaciones en industrias muy diversas entre sí, ya sea el análisis de datos en tiempo real, la integración de fuentes de datos heterogéneas o el impulso de soluciones y servicios que se sustentan en la Inteligencia Artificial. Se ha convertido en una disciplina esencial para las organizaciones a la hora de tomar decisiones que se basan en datos y así obtener ventajas competitivas que les permitan optimizar procesos, mejorar la eficiencia de sus operaciones y, en definitiva, encontrar nuevas oportunidades de negocio.
En MIOTI Tech & Business School estamos siempre actualizados con las últimas novedades tecnológicas y las necesidades de las empresas, y por eso contamos con un máster en Data & Cloud Engineering que cuenta con todos los conocimientos necesarios para desarrollarse en el área de la Ingeniería de Datos y aplicarlo de forma práctica y dinámica en los proyectos de las compañías
Uno de los principales objetivos de MIOTI es fomentar las vocaciones tecnológicas y disminuir la brecha de talento tech en España. Por estos motivos, hemos querido apoyar al equipo Enlil 1, un grupo de estudiantes de Educación Secundaria de diferentes colegios de la Comunidad de Madrid. Estos jóvenes han creado su propio satélite CanSat como parte de un proyecto educativo de la Agencia Espacial Europea (ESA) con el propósito de combatir las consecuencias del cambio climático.
¿Cómo funciona?
Mediante el monitoreo de ríos y arroyos, su innovadora solución busca reducir el riesgo de inundaciones y proteger a las comunidades con mayores posibilidades de sufrirlas. El equipo, con el apoyo de MIOTI Tech & Business School y MIOTI Data Consulting, ha logrado desarrollar esta solución y avanzar en la Competición CanSat Madrid 2023 quedando en el top 4 entre más 200 equipos y obteniendo el galardón al Mejor Proyecto Técnico.
El satélite CanSat diseñado por Enlil 1 es una pequeña maravilla tecnológica que cabe en una lata de refresco. Este tipo de satélite es muy utilizado en las clases de ingeniería debido a su pequeño tamaño y suele lanzarse desde un cohete, globo meteorológico o avión.
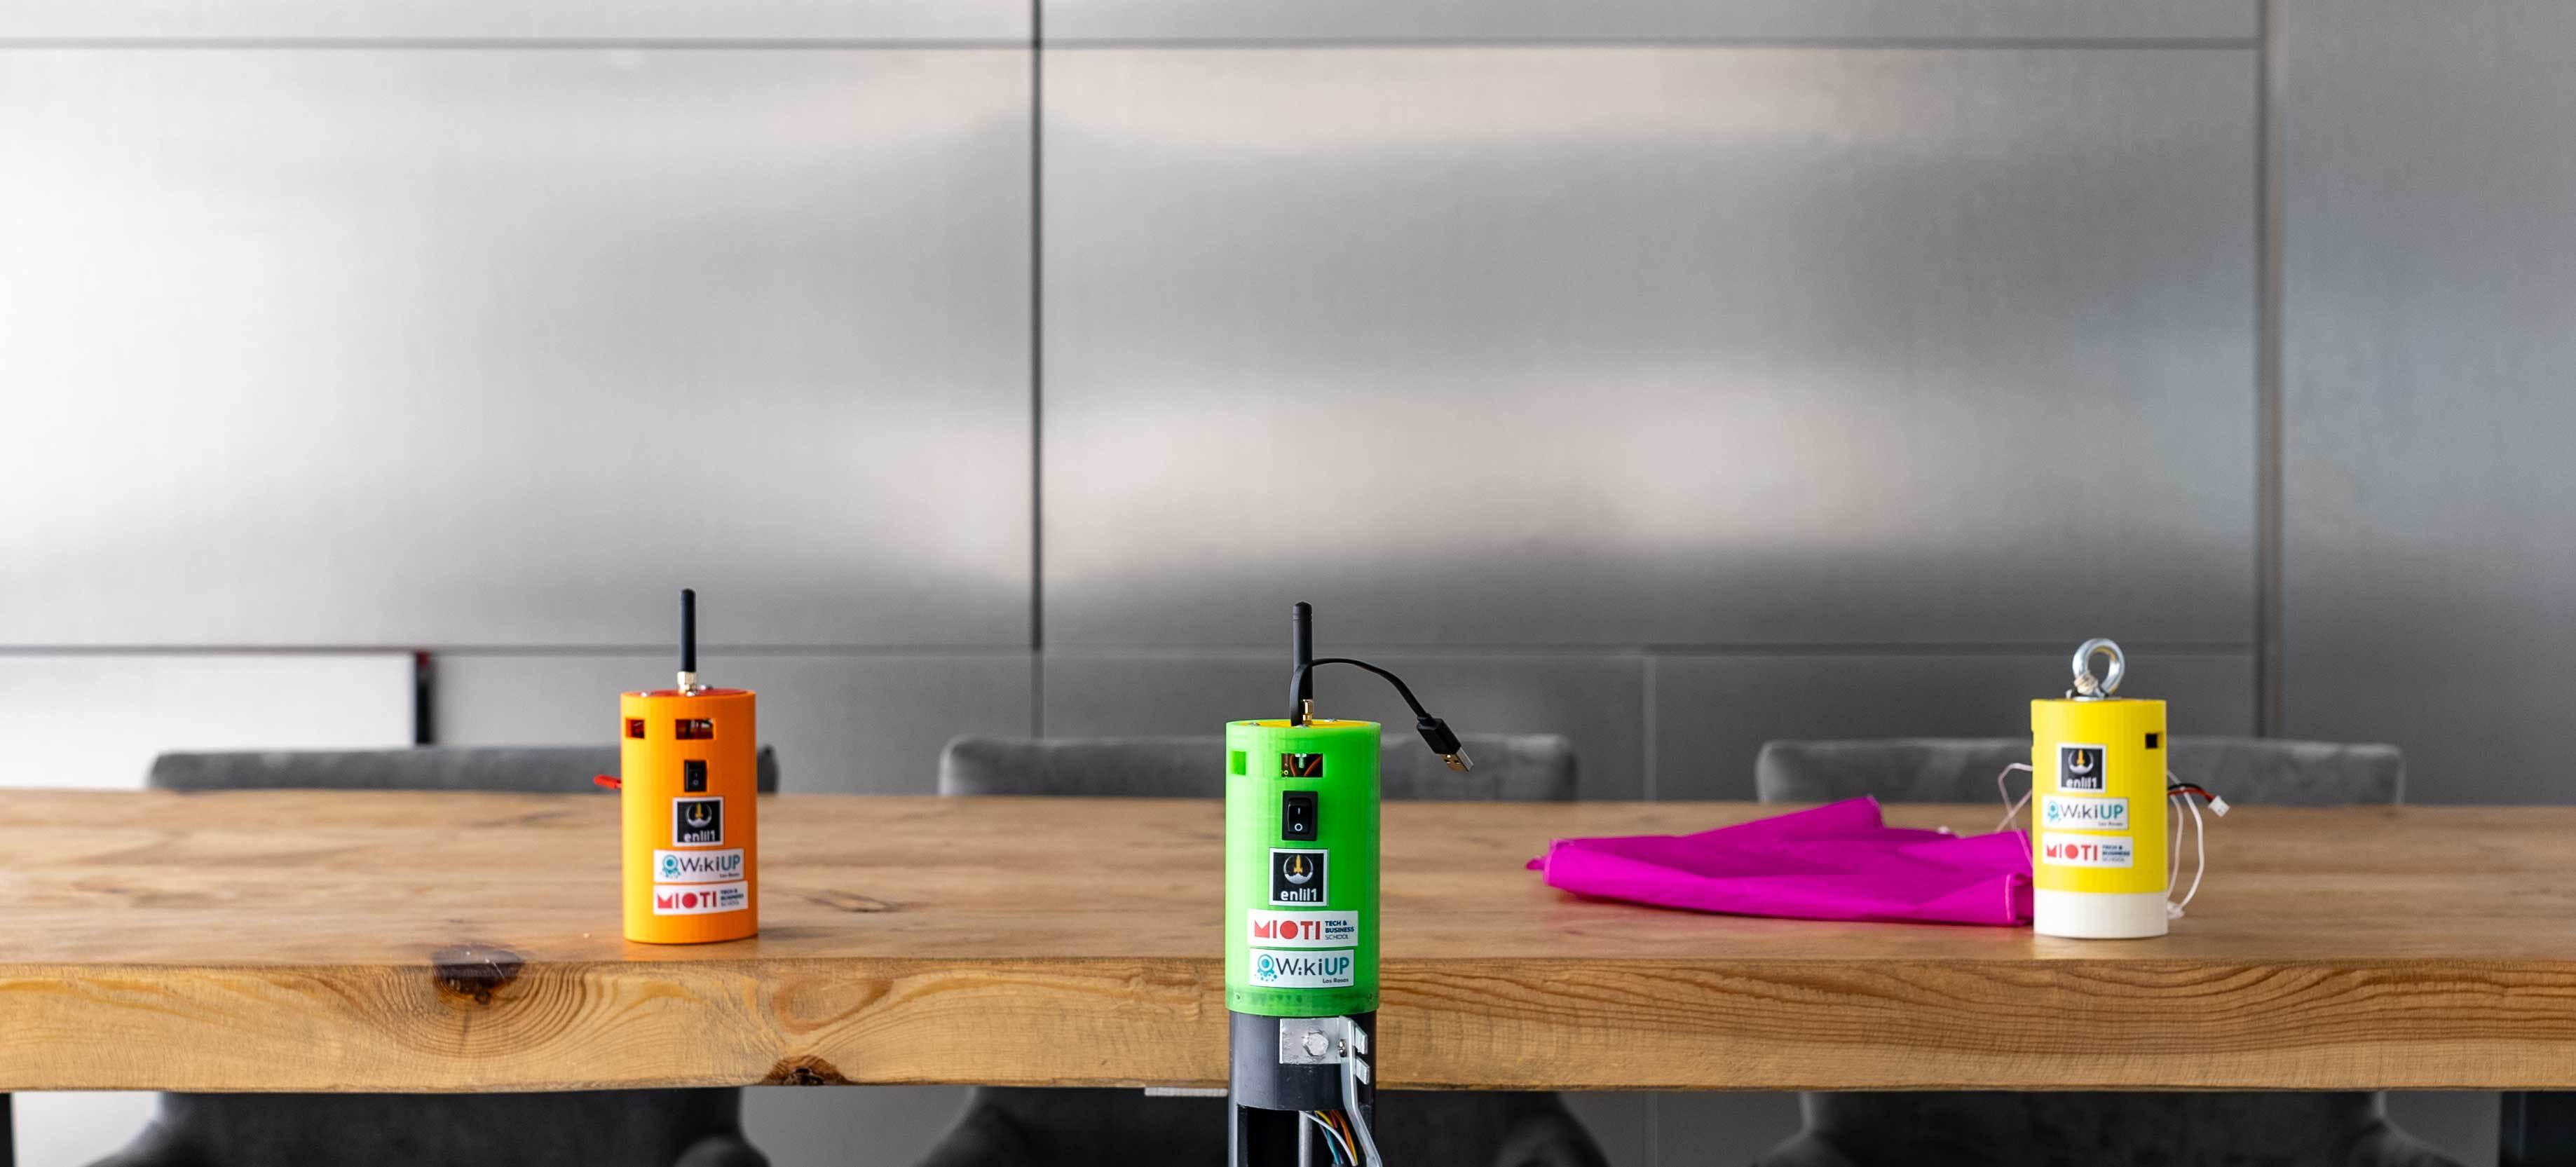
Su principal misión es recopilar datos de presión atmosférica, temperatura y humedad relativa, que se envían a la estación terrestre a través del módulo de comunicaciones LoRa. Se trata por tanto de una herramienta crucial para monitorizar ríos y arroyos donde los desbordamientos e inundaciones son una amenaza constante. De hecho, 5 millones de personas viven en España en zonas en riesgo de inundación.
¿Cuál ha sido nuestro papel en el proyecto?
Los estudiantes han tenido acceso a la formación en Internet of Things (IoT) de la escuela de negocios, lo que les ha permitido aplicar los conocimientos adquiridos en su proyecto, así como ayudándoles a preparar todo el material audiovisual del proyecto. Además, los expertos de MIOTI Data Consulting han estado a su lado orientándoles durante todo el proceso de programación.
Esta colaboración ha sido fundamental para el desarrollo exitoso del proyecto y demuestra nuestro compromiso con el fomento de nuevas vocaciones tecnológicas y la reducción de la brecha digital en España.
La tecnología, clave para la sostenibilidad del planeta
La solución propuesta por Enlil 1 no solo se limita a la recopilación de datos, sino que también implica el procesamiento y análisis de los mismos. Una vez que estos son transmitidos a una plataforma en la nube a través del satélite CanSat, el centro de control de emergencias recibe y analiza esa información en tiempo real. Esto permite detectar posibles riesgos de inundación y alertar a la población de manera oportuna, reduciendo así los impactos negativos en las comunidades vulnerables.
Su enfoque en la reducción de riesgos de inundaciones y la protección de las comunidades afectadas es valioso y relevante en un momento en que el cambio climático se ha convertido en una preocupación global. “Nos sentimos orgullosos de patrocinar proyectos como el de Enlil 1, que promueve soluciones sostenibles e inspira a los jóvenes a explorar oportunidades tecnológicas en áreas clave para el futuro de nuestro planeta. Esperamos ver cómo esta iniciativa inspira a la próxima generación de líderes tech», destaca la CEO y Co-fundadora de MIOTI, Fabiola Pérez.
En este vídeo puedes descubrir todo el proceso llevado a cabo por el grupo Enlil 1 y cómo han desarrollado esta idea innovadora para reducir los efectos de las inundaciones:
En MIOTI Tech & Business School confiamos en la reducción de la brecha digital a través de la formación en nuevas tecnologías, por eso nuestros programas están en constante actualización, como el Máster en IoT & Data Science o el Máster en Data Science & Deep Learning.
El #DiadeInternet se celebró por primera vez en España en octubre de 2005 a iniciativa de la Asociación de Usuarios de Internet (aui.es). En la primera edición se organizaron 534 eventos por todo el país y más de 200 entidades públicas y privadas suscribieron la Declaración de Principios para construir la Sociedad de la Información.
En noviembre de 2005, la Cumbre Mundial sobre la Sociedad de la Información (CMSI) a instancias de la Asociación de Usuarios de Internet y tras conocer el éxito de la celebración en España, acordó solicitar a la Asamblea General de las Naciones Unidas (ONU) que declarase un Día Mundial de Internet para celebrarlo globalmente en todo el planeta.
La ONU acordó fijar el 17 de mayo, día dedicado a las Telecomunicaciones, añadiéndole el Día Mundial de la Sociedad de la Información para promover la importancia de las TIC y los diversos asuntos relacionados con la Sociedad de la Información planteados en la CMSI. En noviembre de 2006, la Conferencia de Plenipotenciarios de la UIT decidió celebrar ambos eventos, Día Mundial de las Telecomunicaciones y de la Sociedad de la Información, el 17 de mayo. En la versión actualizada de la Resolución 68 se invita a los Estados Miembros y Miembros de Sector a celebrar anualmente dicho día.
Cada 17 de mayo se celebra un acontecimiento que busca destacar la importancia que tiene esta herramienta en nuestras vidas y en la sociedad en general. Desde su creación, internet ha revolucionado la forma en que interactuamos, nos comunicamos y accedemos a la información.
Retos para la conectividad segura y global
Para empezar, es importante señalar que internet ha sido una de las innovaciones más disruptivas de la historia reciente. Desde su creación en la década de 1960, ha evolucionado constantemente, y hoy en día es una herramienta esencial en casi todos los aspectos de nuestra vida. Desde el trabajo hasta el entretenimiento, pasando por la educación, la comunicación y el acceso a la información, internet ha transformado la forma en que interactuamos con el mundo que nos rodea.
Sin embargo, es importante reconocer que esta herramienta también tiene sus desafíos. Uno de los mayores problemas relacionados con su uso es la privacidad y la seguridad. En un mundo cada vez más conectado, la información personal se ha vuelto cada vez más vulnerable a la exposición y el robo. Además, el aumento del ciberacoso, la desinformación y otros comportamientos negativos en la red ha llevado a que se cuestione si los beneficios de internet superan los riesgos.
A pesar de estos desafíos, el Día Mundial de Internet sigue siendo una fecha importante para celebrar ya que nos permite conectarnos con personas de todo el mundo, acceder a información que de otra manera sería imposible y permitir la colaboración y la innovación a escala global. Además, internet ha sido una herramienta fundamental para la creación de comunidades online que permite que personas con intereses comunes se conecten, compartan información y colaboren en proyectos.
El tema de este año: Ciudadanía digital, derechos y oportunidades
El tema de este año del es «Ciudadanía Digital, Derechos y Oportunidades«. El Consejo de Europa ha presentado recientemente la «Declaración sobre derechos y principios digitales» situando a los valores de la UE y a sus ciudadanos en el centro de la transformación digital con el objetivo de garantizar que la UE alcance sus objetivos de transformación digital en consonancia con sus valores. En España, el Gobierno ha elaborado la «Carta de Derechos Digitales» con el objetivo de poner a nuestro país a la vanguardia de Europa en la protección de los derechos de la ciudadanía en el ámbito digital.
Por eso, la asociación sin ánimo de lucro del día mundial de internet ha presentado el “Decálogo para impulsar la ciudadanía digital”, cuyo propósito no es otro que garantizar un uso seguro y responsable de internet desde la protección de los más jóvenes hasta el acceso universal a la red. Los puntos que desarrolla la memoria son:
Situar a las personas y sus derechos en el centro
Velar porque los nuevos espacios digitales sean espacios de derecho. Se deben respetar los derechos ya existentes en el mundo analógico y trabajar para impulsar los derechos que nos demanda este ámbito, como el derecho a la privacidad, al olvido, a la desconexión digital o a la no discriminación algorítmica, tal y como se recoge en la Carta de Derechos Digitales de España.
Aumentar y garantizar la accesibilidad y, por tanto, la inclusión de las personas
La inclusión de todas las personas exige garantizar la accesibilidad, que es la condición que deben cumplir los entornos, procesos, bienes, productos y servicios, así como los objetos, instrumentos, herramientas y dispositivos para ser comprensibles, utilizables y practicables por todas las personas en condiciones de seguridad y de la forma más autónoma y natural posible.
Garantizar la seguridad y protección de las personas en el entorno digital
Promover el uso seguro de las tecnologías digitales para los ciudadanos que les permita reforzar su confianza en el ámbito digital, atendiendo al nivel de conocimientos o cercanía hacia la tecnología de colectivos específicos, como es el caso de las personas mayores. Para ello, será necesario dotarles de conocimientos, habilidades y herramientas en materia de ciberseguridad, a través de proyectos, campañas de concienciación y capacitación y servicios de soporte especializados, que les ayuden a la hora de incorporar medidas y hábitos con los que incrementar su nivel de protección frente a las amenazas de Internet.
Alfabetizar y capacitar para el uso de las tecnologías en los desempeños de las personas
Fomentar políticas públicas para la difusión, dotación y reconocimiento de los centros de competencias digitales, sus profesionales y las redes de las que forman parte como espacios de referencia en España donde la ciudadanía puede adquirir y practicar de forma libre y gratuita las habilidades digitales necesarias para el desempeño de sus derechos y metas personales y profesionales. El papel de estos espacios y recursos es fundamental en la creación de un ciudadanía crítica y reflexiva que pueda abordar los retos de la transformación digital y, a la vez, han de ser reconocidos como espacios públicos esenciales en la garantía del cumplimiento de los derechos digitales de la ciudadanía.
Promover una Inteligencia Artificial ética, transparente y responsable
Desarrollar una IA ética que genere confianza y transparencia en su uso para potenciar el efecto positivo que puede tener en la sociedad y en la economía. Prestar especial atención en áreas como privacidad y protección de datos, salud, servicios públicos o entorno laboral, evitando la discriminación y los sesgos por diferentes causas. Empoderar a los ciudadanos para que puedan beneficiarse de las ventajas que aporta la tecnología y poder tomar sus propias decisiones. Facilitar la supervisión e intervención humana en decisiones que produzcan efectos en su esfera personal y patrimonial. En este webinar sobre Inteligencia Artificial del profesor de MIOTI, Carlos Picazo, puedes ver un caso real de la importancia de esta tecnología.
Facilitar el acceso a la administración digital
Una administración digital debe promover, velar y apostar por los datos y estándares abiertos, así como por la colaboración y el entendimiento de las tecnologías digitales junto a la sociedad civil y las empresas, facilitando una ciudadanía digital que evite el asistencialismo tecnológico y que impulse medidas de empoderamiento y capacitación digital de sus ciudadanos, particularmente de los más vulnerables, como son las personas con discapacidad, los mayores y otros colectivos en riesgo de exclusión digital.
Contribuir al desarrollo sostenible y a la implicación de todos los agentes
Capacitar y actualizar a los ciudadanos de manera que sean conscientes del desarrollo tecnológico según les afecta y hagan uso de las nuevas tecnologías de una manera sostenible desde el punto de vista medio ambiental, pero también desde el punto de vista de un desarrollo humanista de la misma.
Impulsar los derechos digitales en los nuevos desarrollos normativos
Prestar especial atención a las nuevas reformas legislativas, apoyándolas y dotándolas de los adecuados recursos que las hagan viables y efectivas en el contexto digital para todos los ciudadanos.
Promover la participación en el entorno digital
Partir del respeto pleno del derecho a la dignidad, libertad, intereses y preferencias. Impulsar una participación y una vida social efectiva de manera que todas las personas, estén contextualizadas en la Sociedad Digital y puedan ocupar el papel que les corresponde, en igualdad de condiciones y sin discriminaciones.
Dotar de los recursos necesarios para llevar estos principios a la práctica
Desarrollar políticas y acciones que faciliten el acceso a los equipos, aplicaciones, conectividad, formación e información necesarios para la vida digital de todas las personas. Implementar planes con suficiencia de recursos, que estén garantizados en el tiempo y que se comprometan formalmente. Prestar especial atención a los colectivos con mayor riesgo de exclusión y promover las oportunidades derivadas de una ciudadanía digital plena.
El Día Mundial de Internet es una oportunidad para reflexionar sobre el papel que esta tecnología tiene en nuestras vidas y en la sociedad en general. Aunque hay desafíos asociados con su uso, internet sigue siendo una herramienta vital para la comunicación, la educación, la innovación y el entretenimiento. Desde MIOTI Tech & Business School trabajamos juntos para abordar los desafíos que enfrentamos en la red en materia de seguridad, accesibilidad y privacidad.
¿Qué es la Inteligencia Artificial?
La Inteligencia Artificial (IA) es un campo de la informática y la tecnología que se enfoca en desarrollar algoritmos y sistemas capaces de realizar tareas que normalmente requieren de inteligencia humana, como el aprendizaje, la resolución de problemas, la toma de decisiones y el reconocimiento de patrones.
La IA se basa en el procesamiento de grandes cantidades de datos y en el uso de algoritmos que permiten a las máquinas aprender de manera autónoma y adaptarse a situaciones nuevas. Esto se logra a través de técnicas como el aprendizaje automático (machine learning), el procesamiento del lenguaje natural (PLN), el computer vision o la robótica, entre otros.
La IA tiene una amplia variedad de aplicaciones en la vida cotidiana, como los sistemas de recomendación de productos y servicios, los asistentes virtuales de voz, los vehículos autónomos, la detección de fraudes y la detección de enfermedades a través de imágenes médicas.
¿Cuál es su origen?
El origen de la Inteligencia Artificial se remonta a la década de 1950, cuando los científicos comenzaron a investigar cómo se podría simular la inteligencia humana en los ordenadores. Durante este periodo, se desarrollaron los primeros programas informáticos capaces de realizar tareas como jugar al ajedrez y resolver problemas matemáticos.
En 1959 se produjo uno de los hitos más importantes en la historia de la IA cuando el científico Arthur Samuel desarrolló el algoritmo de aprendizaje automático el cual permitió a las máquinas mejorar su capacidad de realizar tareas a medida que procesaban más datos y adquirían más experiencia.
En la década de 1960, el científico John McCarthy acuñó el término «Inteligencia Artificial» y organizó la Conferencia de Dartmouth, que es considerada como el nacimiento oficial del campo de la IA.
Desde entonces, la IA ha evolucionado gracias a los avances en la tecnología de la computación y al desarrollo de nuevas técnicas de aprendizaje automático. En la actualidad, la IA tiene una amplia variedad de aplicaciones en la vida cotidiana. Se espera que siga creciendo y transformando la forma en que interactuamos con la tecnología y el mundo que nos rodea.
Tipos de Inteligencia Artificial
- IA Reactiva: Se enfoca en la toma de decisiones basadas en la información que se recibe en tiempo real. Es decir, se basa únicamente en la información que se presenta en el momento y no tiene la capacidad de aprender de experiencias pasadas. Los chatbots que se utilizan para la atención al cliente, por ejemplo.
- IA Basada en la Memoria: Este tipo de IA sí utiliza la información histórica para tomar decisiones. Por lo tanto, es capaz de aprender y mejorar con el tiempo. Un ejemplo son los sistemas que recomiendan películas a los usuarios que se basan en sus preferencias para recomendarles nuevos productos.
- IA Basada en la Teoría de la Mente: Se centra en la capacidad de entender las emociones y pensamientos de los demás. Por lo tanto, es útil para aplicaciones como los chatbots de atención al cliente que deben entender las necesidades y emociones de los usuarios.
- IA Basada en la Autoconciencia: Pone atención en la capacidad de la máquina para comprender su propio estado y emociones. Se espera que esta tecnología sea útil en aplicaciones como la robótica, donde los robots deben ser capaces de entender su propio estado y comportamiento.
- IA General: Está enfocado en crear una máquina que pueda pensar y aprender como un ser humano. Aunque todavía está en fase de investigación y desarrollo y no hay sistemas comerciales disponibles en la actualidad.
Muchos sistemas de IA utilizan una combinación de diferentes técnicas y enfoques para lograr sus objetivos. Por ejemplo, un sistema de reconocimiento de voz puede utilizar técnicas de aprendizaje automático para mejorar la transcripción y la comprensión del lenguaje natural.
En MIOTI Tech & Business School somos expertos en Inteligencia Artificial y en sus aplicaciones a startups y empresas de mayor tamaño, todo con el objetivo fundamental de ofrecer a nuestros alumnos los mejores programas que les permitan reinventarse o actualizarse profesionalmente, como nuestro Máster en Deep Learning o la doble titulación de Data Science & Deep Learning.
Tras la I Edición de nuestro Data Talent Innovation Summit, hemos elaborado el informe ‘Las claves para atraer y retener talento tech’ a través de las conclusiones extraídas de los expertos en gestión de talento de empresas como Mercedes-Benz, Ryanair, Renault o Repsol, que señala que el liderazgo de los profesionales tecnológicos dentro de los proyectos, equipos o empresas es una de las principales claves para retenerles en la compañía.
Mientras la demanda de perfiles digitales en España continúa creciendo, la formación en habilidades tecnológicas sigue siendo insuficiente. La Asociación Española para la Digitalización, DigitalES, afirma que existen más de 120.000 vacantes tecnológicas sin cubrir en el país, lo que supone un 70% más con respecto a 2021.
En este sentido, Fabiola Pérez, CEO y co-fundadora de MIOTI afirma que “teniendo en cuenta que el periodo de rotación actual en las empresas no supera los dos años de permanencia y la probabilidad de que los profesionales tecnológicos se vayan en el primer año es del 50%, hay que buscar soluciones diferentes para un talento diferente y pensar qué empresas buscan los candidatos, en lugar, de qué candidatos buscamos para nuestra empresa”.
Esta falta de profesionales en el sector digital ha creado una competencia feroz entre las empresas por atraer y retener a los mejores talentos digitales. Para ello, muchas empresas han tenido que invertir en la creación de equipos de recursos humanos especializados en la búsqueda y selección de perfiles tecnológicos, así como en estrategias de employer branding que les permitan diferenciarse y atraer a los mejores talentos tech.
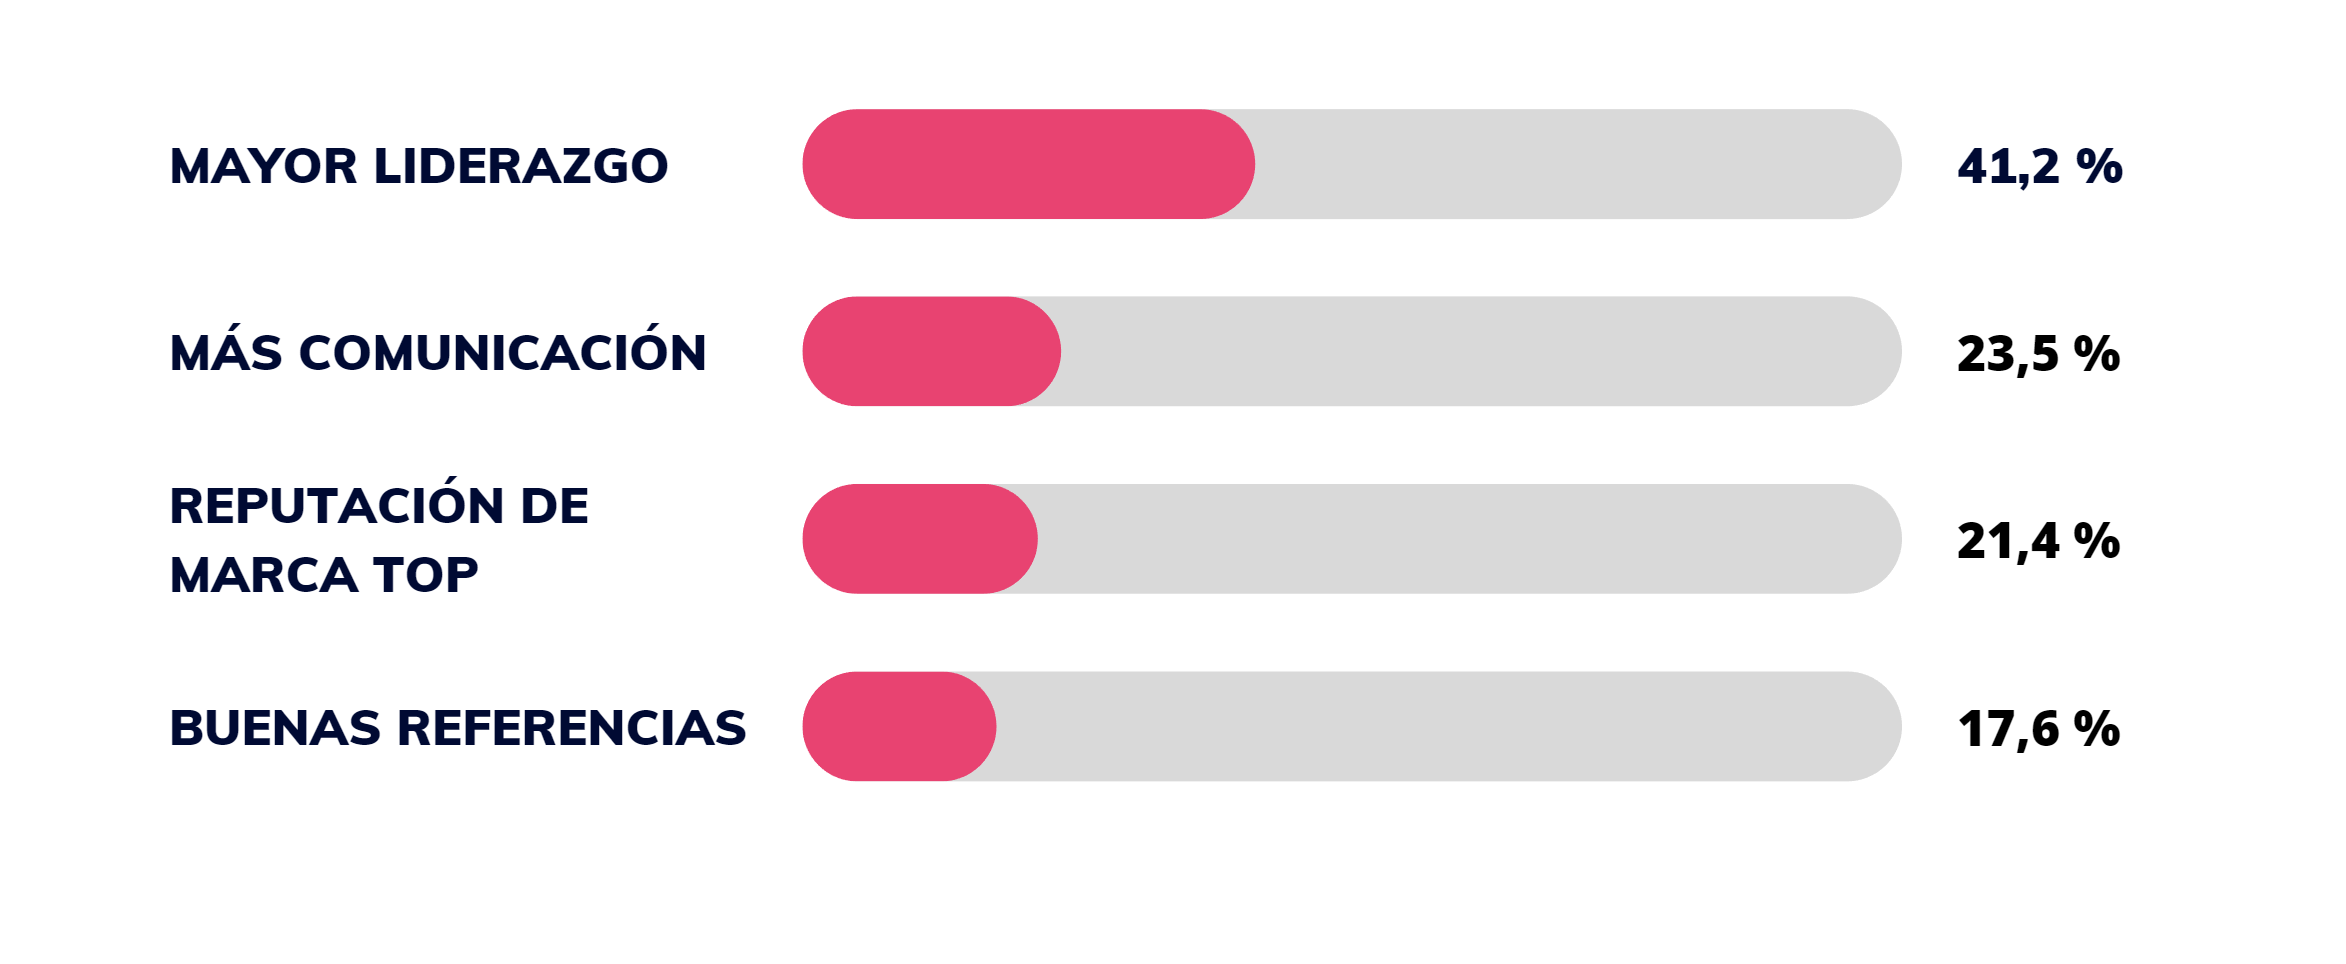
Más del 41% de los profesionales de RRHH señalan el liderazgo como clave
En el informe, que está dividido en el reto, las oportunidades y entrevistas a los candidatos más deseados, con el objetivo de entender mejor las necesidades y demandas de estos profesionales, ha permitido a los expertos en gestión de talento establecer soluciones para implementar o mejorar en sus empresas.
En concreto, el 19,05% de los asistentes considera que la flexibilidad en el trabajo es una condición atractiva para que un candidato elija una empresa para trabajar o para permanecer en la suya, pero no es la condición más valorada por estos profesionales. De hecho, el 41,18% de los expertos de recursos humanos cree que los candidatos quieren mayor liderazgo dentro de sus proyectos, equipos o empresas. Esta percepción demuestra que el talento tecnológico tiene una visión clara de su valor en el mercado laboral actual y son conscientes de que su perfil es altamente demandado.
El 38,20% indicaron el plan de carrera interno de la empresa como uno de los aspectos más relevantes, puesto que la mayoría opina que el “estancamiento” es el mayor obstáculo para los candidatos, es decir, la falta de oportunidades de crecimiento y desarrollo profesional dentro de una compañía disminuye en gran medida su motivación y formación a la vez que aumenta la incertidumbre dentro de la organización.
Aspectos como la cultura empresarial moderna, la imagen de marca atractiva o la reputación interna de la compañía son cualidades que los candidatos tienen en cuenta a la hora elegir una u otra empresa. La comunicación dentro de las organizaciones para expresar sus necesidades o inquietudes también es un factor fundamental. Asimismo, la transparencia y el diálogo abierto fomentan la confianza y el compromiso de los trabajadores. Para esta parcela, abrir canales de comunicación seguros entre todas las partes implicadas es de vital importancia.
Una visión global de la demanda de pérfiles tech
Por su parte, la directora del área de Business Management & Operations del Martin Trust Center for MIT Entrepreneurship, Susan Neal, aporta su visión sobre la situación actual en el mercado laboral de talento digital en Estados Unidos. A pesar de los recortes en la fuerza laboral de muchas empresas tras el COVID-19, incluyendo talento digital, la demanda de perfiles con habilidades especializadas en áreas como inteligencia artificial, análisis de datos y ciberseguridad, continúa a la alza en la actualidad: “Hay 1,9 vacantes por cada persona que busca empleo”, subraya.
Además, en un mundo cada vez más dinámico y competitivo, la gestión de recursos humanos se convierte en un factor clave para el éxito de las empresas de todo el mundo. Por eso, “conocer las preferencias y necesidades de los empleados se vuelve imprescindible para diseñar estrategias que permitan atraer y retener talento. Gracias a la colaboración de los expertos en gestión del talento y de algunos de los perfiles más demandados, hemos podido concluir que los candidatos buscan tener más responsabilidad en las compañías y empresas que se preocupen por su crecimiento y desarrollo profesional, que inviertan en su formación para seguir creciendo y aprendiendo, y que se mantengan actualizadas en la innovación de su ámbito laboral”, concluye Fabiola Pérez, CEO y co-fundadora de MIOTI Tech & Business School.
Si quieres consultar el informe completo sobre Las claves de atraer y retener talento tech puedes hacerlo a través de este enlace.
¿Qué es el Edge Computing?
El Edge Computing, o cómputo en el borde, es una tecnología emergente que busca llevar la potencia de procesamiento y el almacenamiento de datos lo más cerca posible de los dispositivos y usuarios finales, en lugar de enviarlos a través de una red centralizada a una nube o centro de datos remoto.
En lugar de depender de una infraestructura de red centralizada, el Edge Computing se basa en una arquitectura distribuida en la que los datos se procesan y almacenan en dispositivos cercanos al borde de la red, como routers, gateways, servidores perimetrales, dispositivos IoT o móviles, y otros nodos de red. Esto permite que los datos se procesen y se actúe sobre ellos en tiempo real, reduciendo la latencia y mejorando la eficiencia y el rendimiento de las aplicaciones. Según un informe de Gartner, se espera que para 2025, el 75% de los datos generados por empresas se creen y procesen fuera de los centros de datos tradicionales, lo que indica la importancia creciente del Edge Computing.
El Edge Computing es especialmente relevante para aplicaciones que requieren una baja latencia, una alta velocidad de procesamiento y una gran cantidad de datos en tiempo real, como la inteligencia artificial, la realidad virtual, los vehículos autónomos, la automatización industrial, las ciudades inteligentes, el monitoreo ambiental, la salud y muchas otras áreas.
Diferencias entre Edge Computing y Cloud Computing
El Edge Computing y el Cloud Computing son dos tecnologías que comparten algunos aspectos comunes, pero que difieren significativamente en su enfoque y alcance. A continuación, se presentan algunas de las principales diferencias entre estas dos tecnologías:
- Ubicación de los recursos: El Cloud Computing se basa en una arquitectura centralizada en la nube, donde los recursos de procesamiento y almacenamiento se ubican en centros de datos remotos, mientras que el Edge Computing se basa en una arquitectura distribuida, donde los recursos se ubican en dispositivos cercanos al borde de la red.
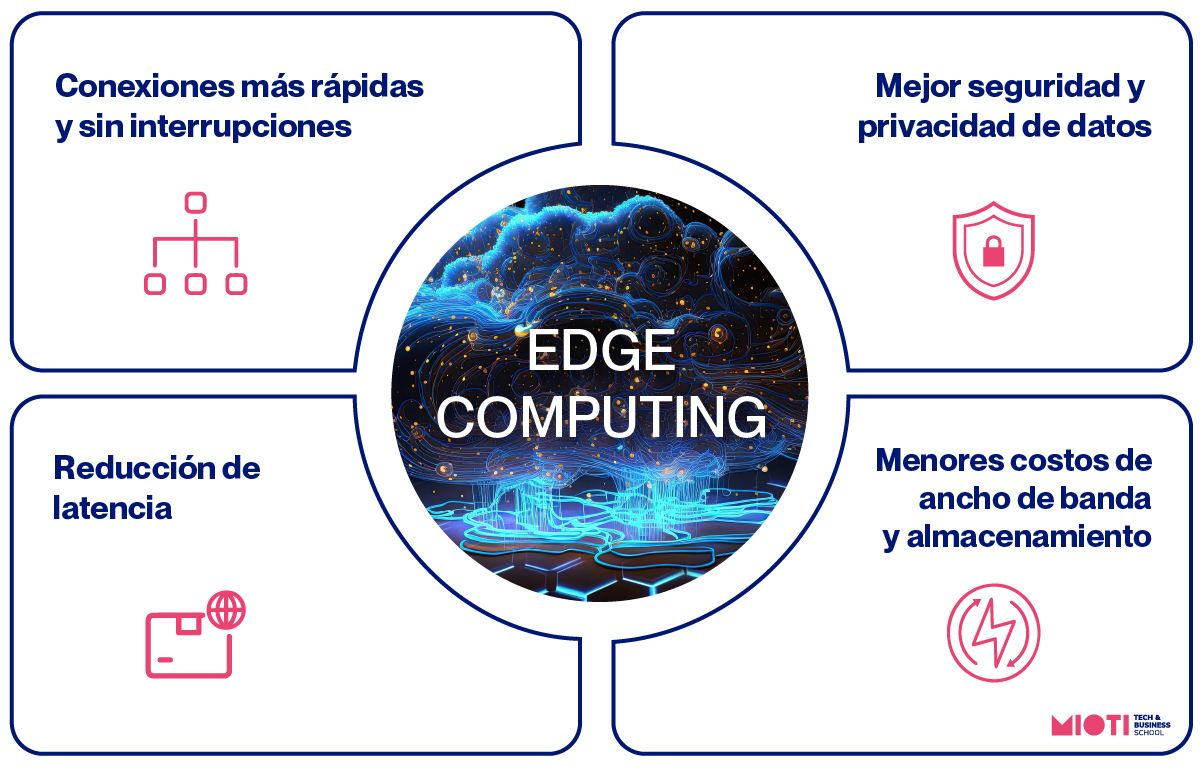
- Latencia: El Edge Computing ofrece una baja latencia al procesar y actuar sobre los datos en tiempo real, lo que lo hace ideal para aplicaciones que requieren una respuesta rápida y precisa, mientras que el Cloud Computing tiene una latencia mayor debido a la distancia entre los centros de datos y los usuarios.
- Ancho de banda: El Cloud Computing requiere un ancho de banda mayor para transferir grandes cantidades de datos entre los usuarios y los centros de datos remotos, mientras que el Edge Computing utiliza el ancho de banda de manera más eficiente al procesar y almacenar los datos en el borde de la red.
- Escalabilidad: El Cloud Computing ofrece una mayor escalabilidad al permitir el acceso a una gran cantidad de recursos de procesamiento y almacenamiento en la nube, mientras que el Edge Computing se centra en la escalabilidad horizontal, es decir, en agregar más dispositivos perimetrales para ampliar la capacidad de procesamiento y almacenamiento.
- Seguridad: El Edge Computing ofrece una mayor seguridad al procesar y almacenar los datos en los dispositivos cercanos al borde de la red, reduciendo la necesidad de transferir datos a través de una red centralizada, mientras que el Cloud Computing depende de la seguridad de la infraestructura centralizada en la nube.
Aplicaciones y tendencias relacionadas al Edge Computing
El Edge Computing se ha convertido en una tecnología cada vez más importante debido a su capacidad para procesar y almacenar datos en tiempo real en dispositivos perimetrales cercanos a los usuarios.
Internet de las cosas (IoT)
El Edge Computing es fundamental para la IoT, ya que permite el procesamiento de datos y el análisis en tiempo real en los dispositivos perimetrales, mejorando la eficiencia y la seguridad en las aplicaciones IoT.
Automatización Industrial
El Edge Computing se está utilizando cada vez más en aplicaciones de automatización industrial para la monitorización de maquinarias y la detección de fallos en tiempo real, lo que reduce el tiempo de inactividad y los costos operativos.
Vehículos Autónomos
Los vehículos autónomos requieren una gran cantidad de datos en tiempo real para tomar decisiones de manera autónoma, por lo que el Edge Computing se está utilizando para procesar y analizar estos datos en los dispositivos perimetrales cercanos a los vehículos, reduciendo la latencia y mejorando la seguridad.
Streaming de video
El Edge Computing se utiliza en servicios de streaming de video para reducir la latencia y mejorar la calidad del servicio al procesar y almacenar el contenido en dispositivos perimetrales cercanos a los usuarios.
Ciudades Inteligentes
El Edge Computing se está utilizando en aplicaciones de ciudades inteligentes para el procesamiento y análisis de datos en tiempo real, mejorando la eficiencia y la seguridad en áreas como el transporte, la energía y la gestión de residuos.
En cuanto a las tendencias, se espera que el Edge Computing sea una tecnología fundamental en la próxima generación de redes de comunicación 5G, lo que permitirá la entrega de servicios y aplicaciones en tiempo real en una variedad de industrias. Además, la integración de la inteligencia artificial y el aprendizaje automático en el Edge Computing se espera que ofrezca nuevas oportunidades para la innovación.
Desde MIOTI Tech & Business School estamos siempre a la vanguardia tecnológica por eso actualizamos constantemente nuestro programas, como el Máster en Data & Cloud Engineering, y ofrecemos formaciones específicas en estas materias con empresas punteras en el sector como Barbara IoT, que puedes ver en este vídeo de nuestra masterclass ‘Edge Computing: La mayor revolución desde Cloud‘.
¿Qué es la ciberseguridad?
La ciberseguridad es el conjunto de medidas y prácticas que se emplean para proteger los sistemas informáticos, las redes y los datos de ataques y amenazas cibernéticas. Se trata de un conjunto de técnicas y estrategias destinadas a prevenir, detectar y responder a los intentos de acceso no autorizado, robo de información, sabotaje, virus informáticos y otras amenazas que se pueden presentar en el mundo digital.
El sector de la seguridad tecnológica está en auge desde la explosión de internet. En la actualidad, casi todas las empresas, organizaciones públicas y personas utilizan sistemas y dispositivos conectados a la red para almacenar y compartir información importante. Los datos sensibles y confidenciales, como la información financiera, la propiedad intelectual, los datos personales y los secretos comerciales, son cada vez más vulnerables a las amenazas cibernéticas.
Los expertos de la industria se dedican a proteger esos datos mediante el uso de herramientas y técnicas tales como la autenticación, los cortafuegos, la encriptación, la monitorización de redes, el control de accesos o la auditoría de seguridad, entre otros.
¿Por qué es importante?
La ciberseguridad es importante porque el uso de sistemas y dispositivos conectados a Internet se ha vuelto omnipresente en nuestras vidas diarias. Desde la banca online y las compras hasta el correo electrónico y las redes sociales, casi todas las actividades que realizamos en internet involucran el intercambio de datos y la comunicación a través de la red. A medida que aumenta la cantidad de datos que se transmiten y almacenan en línea, la necesidad de proteger estos datos y sistemas de amenazas cibernéticas también aumenta.
Los riesgos cibernéticos incluyen virus informáticos, malware, phishing, ataques de denegación de servicio, robos de identidad, fraudes en línea y robo de información, entre otros. Si no se toman medidas para proteger los sistemas y los datos de estas amenazas, los usuarios pueden enfrentarse a graves consecuencias, como la pérdida de datos sensibles, la interrupción de los servicios, el robo de identidad o el daño a la reputación de la persona.
Además, la ciberseguridad es esencial para proteger la privacidad y la seguridad de los usuarios. En un mundo cada vez más conectado, los datos personales y sensibles, como la información financiera y la información de identificación personal, son vulnerables a la explotación por parte de los delincuentes online.
Las empresas y las organizaciones también dependen de la ciberseguridad para proteger sus activos críticos, incluida la propiedad intelectual, la información financiera y los secretos comerciales. Las violaciones de seguridad online pueden resultar en la pérdida de información valiosa, el mal funcionamiento de los servicios y la pérdida de la confianza de los clientes.
Consejos de ciberseguridad para padres
La ciberseguridad es una preocupación cada vez más importante para padres y madres, ya que sus hijos e hijas son cada vez más activos en la red y desde una edad cada vez más temprana, dejándoles expuestos y vulnerables ante los peligros de internet. Aquí te presentamos algunos tips de ciberseguridad pensados precisamente para ellos:
Establece reglas claras
Es importante establecer normas claras sobre el uso de Internet y los dispositivos electrónicos. Esto puede incluir horarios para el uso de dispositivos y aplicaciones, restricciones de acceso a ciertos sitios web y aplicaciones, y límites en la cantidad de tiempo que se pasa online.
Educa a tus hijos sobre los riesgos en internet
Asimismo, es clave educar a tus hijos sobre los riesgos que existen en la red, incluyendo el acoso cibernético, el grooming, el phishing, el robo de identidad, entre otros. Enséñales a reconocer estas amenazas y cómo protegerse.
Control de acceso paternal
Utiliza herramientas de control parental para controlar el acceso de tus hijos a Internet y aplicaciones específicas. Estas herramientas te permiten bloquear sitios web y aplicaciones, así como supervisar la actividad en línea de tus hijos.
Mantén tus dispositivos actualizados
Asegúrate de mantener tus dispositivos electrónicos y programas actualizados con las últimas versiones de seguridad. Las actualizaciones a menudo incluyen parches de seguridad para proteger tu dispositivo de las últimas amenazas.
Utiliza contraseñas seguras
Del mismo modo, es importante asegurarse de que estamos utilizando contraseñas seguras y únicas para tus cuentas online. Utiliza contraseñas largas y complejas que incluyan letras, números y símbolos y evita utilizar la misma contraseña para múltiples cuentas o plataformas.
Evita el phishing
Enséñales a tus hijos a evitar los correos electrónicos sospechosos y los mensajes de texto que pueden ser phishing. Estos mensajes pueden parecer legítimos, pero en realidad buscan engañar a las personas para que proporcionen información personal o financiera.
Supervisa la actividad online
Vigilar la actividad online de tus hijos y habla con ellos sobre lo que están haciendo en línea también es muy importante. Si detectas actividades sospechosas, habla con ellos y ayúdalos a comprender las consecuencias de sus acciones en internet.
Aplicaciones de ciberseguridad útiles para madres y padres
Existen muchas aplicaciones de ciberseguridad que pueden ayudarnos que pueden ayudar a madres y padres en la exposición de los peligros de internet de nuestros hijos. A continuación, os montramos algunas de las que pueden ayudarnos en esta tarea:
- Norton Family: Esta aplicación es una excelente opción para los padres que quieren tener un control más detallado sobre las actividades online de sus hijos. Norton Family permite a los padres ver los sitios web que sus hijos visitan, bloquear sitios web y controlar el tiempo de uso de internet.
- Kaspersky Safe Kids: Kaspersky Safe Kids ofrece una variedad de herramientas para ayudar a los padres a proteger a sus hijos online. Los padres pueden establecer límites de tiempo, bloquear sitios web inapropiados y recibir alertas cuando sus hijos intentan acceder a contenido inapropiado.
- Qustodio: Qustodio es otra aplicación de ciberseguridad popular para padres. La aplicación ofrece herramientas para monitorear el uso de Internet de sus hijos, incluyendo el seguimiento de la ubicación, el control del tiempo online y la restricción de acceso a contenido inapropiado.
- Mobicip: Mobicip es una aplicación de ciberseguridad diseñada específicamente para niños y jóvenes. La aplicación ofrece la supervisión del historial de navegación.
- Bark: Esta es una aplicación de ciberseguridad que utiliza la Inteligencia Artificial (IA) para ayudar a los padres a detectar signos de acoso escolar, depresión y otros problemas de salud mental. Bark envía alertas a los padres para que puedan intervenir cuando sea necesario.
En MIOTI Tech & Business School tenemos el propósito de orientar y formar a nuestros estudiantes en los peligros de internet si no se utiliza de forma segura y fiable, por eso, este curso lanzamos nuestro Máster en Ciberseguridad, un programa completo sobre los retos que plantea la seguridad con el uso de las últimas tecnologías de vanguardia.
La publicidad programática es una técnica de publicidad digital que ha revolucionado la forma en que se compran y venden anuncios online. En lugar de depender de los vendedores o intermediarios tradicionales, la publicidad programática utiliza tecnología para automatizar el proceso de compra y venta de anuncios. A continuación, vamos a profundizar en lo que es la publicidad programática, su origen, principales tipos, así como ventajas e inconvenientes.
¿Qué es la publicidad programática?
Como decíamos, la publicidad programática es un sistema automatizado que posibilita la compra y venta de espacios publicitarios de manera online por parte de los anunciantes, los cuales utilizan plataformas de compra programática para seleccionar el tipo de audiencia que desean alcanzar, establecer su presupuesto y crear anuncios personalizados. Por otro lado, los editores utilizan plataformas de venta programática para poner a disposición su inventario publicitario y monetizar su contenido digital. La publicidad programática se basa en la tecnología de cookies, que recopila información sobre los usuarios online, como su ubicación, historial de navegación y preferencias. Esta información se utiliza para crear perfiles detallados de los usuarios y ofrecer anuncios personalizados que sean relevantes para ellos.
Origen de la publicidad programática
La publicidad programática comenzó a desarrollarse a principios de la década de los 2000 con la aparición del intercambio de anuncios. Los intercambios de anuncios son plataformas que permiten a los editores vender su inventario publicitario a múltiples compradores simultáneamente, lo que permitió a los editores obtener el mejor precio posible por su inventario y a los compradores acceder a una gran variedad de datos en un único lugar. En la década de 2010, la publicidad programática evolucionó hacia un sistema más sofisticado que utilizaba datos para dirigir anuncios a audiencias específicas. En consecuencia, las plataformas de compra programática se convirtieron en una herramienta esencial para los anunciantes que querían llegar a su audiencia de manera efectiva y eficiente.
Tipos de publicidad programática
Existen diferentes tipos de publicidad programática, entre las que destacan:
Publicidad en tiempo real (RTB)
La publicidad en tiempo real es un tipo de publicidad programática que utiliza subastas en tiempo real para vender espacios publicitarios. Los anunciantes establecen un presupuesto y una estrategia de oferta, y luego compiten con otros anunciantes para comprar espacios publicitarios. El proceso de subasta se lleva a cabo en milisegundos y el anuncio ganador se muestra al usuario.
Publicidad nativa
La publicidad nativa es un tipo de publicidad programática que se integra perfectamente en el contenido del sitio web o la aplicación. Los anuncios nativos son menos intrusivos y tienen una tasa de clics más alta que los anuncios tradicionales.
Publicidad móvil
La publicidad móvil es un tipo de publicidad programática que se muestra en dispositivos móviles como teléfonos inteligentes y tabletas. La publicidad móvil utiliza datos de ubicación para ofrecer anuncios relevantes a los usuarios en función de su ubicación geográfica.
Publicidad en vídeo
La publicidad en video es un tipo de publicidad programática que utiliza videos para promocionar productos o servicios. Los anuncios en video se reproducen antes, durante o después del contenido de video que el usuario está viendo.
Publicidad en redes sociales
La publicidad en redes sociales es un tipo de publicidad programática que se muestra en plataformas de redes sociales como Facebook, Instagram y Twitter. La publicidad en redes sociales utiliza datos demográficos y de comportamiento para dirigir anuncios a audiencias específicas.
Algunos ejemplos de esta publicidad
Estos son solo algunos ejemplos de cómo diferentes empresas han utilizado la publicidad programática de manera innovadora para llegar a su público objetivo de una manera más efectiva.
- Coca-Cola: en una campaña en Brasil, Coca-Cola usó la publicidad programática para personalizar los anuncios de acuerdo con el clima en diferentes ubicaciones geográficas. Los anuncios incluían mensajes como «disfruta de una Coca-Cola fría en este día caluroso» o «calienta tu corazón con una Coca-Cola caliente» según la temperatura en la zona.
- Heineken: la marca de cerveza Heineken usó la publicidad programática en una campaña en Polonia para promocionar su producto entre los jóvenes. Crearon una serie de anuncios que se mostraban solo a usuarios que habían visitado previamente sitios web de universidades o eventos para estudiantes.
- Spotify: en una campaña en Estados Unidos, Spotify utilizó la publicidad programática para crear anuncios personalizados que incluían el nombre de la persona y las canciones que escuchaban. La campaña se basó en datos de la plataforma de música para llegar a los usuarios de manera más efectiva.
- Nike: en la campaña «Risk Everything» en 2014, Nike promocionó su línea de fútbol para el Mundial de Brasil. En esta campaña, Nike utilizó la publicidad programática para personalizar los anuncios de acuerdo con los intereses y comportamientos de los usuarios. Por ejemplo, si un usuario había visitado previamente sitios web de fútbol o buscado información sobre el Mundial de Brasil, se le mostraban anuncios de Nike relacionados con esta temática. También se utilizaron datos de comportamiento de los usuarios, como el tiempo que pasaban en los sitios web de fútbol, para llegar a ellos en momentos clave.
Ventajas de la publicidad programática
La publicidad programática tiene numerosas ventajas entre las que se encuentra, por ejemplo, una mayor eficiencia de los costes ya que permite a los anunciantes comprar inventario y datos a un menor precio ya que se automatiza la mayor parte del proceso.
Además, también aporta una segmentación más avanzada de la audiencia ya que amplía la búsqueda a una gran variedad de factores, lo que posibilita una llegada mucho más exacta y precisa a la audiencia target. Esto va claramente de la mano con la mayor personalización que se puede añadir a los mensajes publicitarios que recibe nuestra audiencia lo que añade un extra de efectividad.
Por otro lado, la publicidad programática también permite a los anunciantes una optimización en tiempo real de sus campañas lo que ofrece la posibilidad de maximizar el rendimiento, la monitorización y el retorno de la inversión.
Inconvenientes de la publicidad programática
Sin embargo, no es oro todo lo que reluce ya que este tipo de publicidad también tiene algunas desventajas como por ejemplo la falta de transparencia ya que, en ocasiones, no se sabe exactamente en qué sitios, webs o aplicaciones se está mostrando la publicidad. Por otro lado, también existe el riesgo de caer en el fraude publicitario ya que existen prácticas fraudulentas en las que se generan impresiones o clics falsos para obtener un beneficio económico.
Otro inconveniente es que la segmentación de los clientes está en manos de los algoritmos y el Big Data lo que puede acarrear una dificultad para llegar al público objetivo, porque, aunque estas herramientas tecnológicas son efectivas, también pueden equivocarse.
El rechazo de los clientes también es un tema a tener en cuenta ya que no todos los usuarios se sienten cómodos cuando entran en una web y ven anuncios de páginas que acaban de visitar; y, sobre todo, cuando aparece ese producto que ha estado viendo hace un momento.
No obstante, es importante mencionar que estos inconvenientes pueden ser minimizados con una buena estrategia y un monitoreo constante.
En MIOTI Tech & Business School somos expertos en la aplicación del Big Data para automatizar procesos, identificar tendencias, realizar modelos de predicción o investigar nuevas líneas de negocio en todas las industrias, incluida la publicitaria, a través de nuestros másteres en Data Science y Big Data, Marketing Data Analytics o Data Estrategy Executive Program.
La Inteligencia Artificial (IA) es la capacidad de las máquinas para realizar tareas que normalmente requieren inteligencia humana, como el aprendizaje, la resolución de problemas y la comprensión del lenguaje natural. Como campo de estudio, la IA nació en la década de 1950 y desde entonces, ha evolucionado significativamente hasta convertirse en una herramienta esencial en numerosas industrias y campos de investigación.
A pesar de sus múltiples beneficios y aplicaciones en diversos campos como por ejemplo la automatización de procesos empresariales, la precisión y eficiencia de los diagnósticos médicos, la optimización de recursos, la prevención de delitos o el desarrollo de dispositivos inteligentes, la IA también ha sido objeto de debate en cuanto a su impacto en la sociedad y la ética.
¿Qué retos tiene por delante la Inteligencia Artificial?
En cuanto a la privacidad y seguridad de los datos, el uso de algoritmos de aprendizaje automático para procesar grandes cantidades de información personal puede plantear riesgos para la privacidad y la seguridad. Además, los algoritmos pueden estar sesgados debido a la falta de diversidad en los conjuntos de datos utilizados para entrenarlos, lo que puede llevar a decisiones discriminatorias.
Otro aspecto preocupante es la toma de decisiones automatizada sin supervisión humana, que puede plantear riesgos en áreas como la justicia penal, la salud y el empleo. La responsabilidad y transparencia también son importantes en el uso de sistemas autónomos, como los vehículos autónomos o los drones, ya que pueden causar daños si no se utilizan de manera responsable.
Es importante abordar estos problemas éticos con políticas y regulaciones adecuadas que garanticen un uso responsable y ético de la inteligencia artificial. Esto incluye el desarrollo de algoritmos justos e imparciales, la supervisión humana en la toma de decisiones automatizada y la transparencia en el uso de sistemas autónomos.
¿Qué están haciendo las empresas respecto al tema?
Cada vez son más las compañías que están tomando medidas para abordar los problemas éticos de la inteligencia artificial. Algunas empresas han establecido equipos internos dedicados a la ética de la inteligencia artificial y han desarrollado códigos de conducta para garantizar un uso responsable y ético de esta tecnología. Además, otras también están trabajando en el desarrollo de algoritmos más justos e imparciales y en la eliminación de sesgos en los datos utilizados para entrenarlos.
Otras empresas están implementando medidas para garantizar la transparencia en el uso de sistemas autónomos y que las decisiones automatizadas sean supervisadas por humanos. Cada vez son más las que se toman en serio los problemas éticos de la inteligencia artificial y trabajan para garantizar un uso responsable y ético de esta tecnología.
¿Y las administraciones públicas?
Los gobiernos y organizaciones están implementando medidas a contrarreloj para regular el marco jurídico de estos problemas. Algunos ejemplos incluyen el Reglamento General de Protección de Datos (RGPD) de la Unión Europea, que establece normas para la protección de datos personales, y la Ley de Privacidad del Consumidor de California en Estados Unidos (CCPA), que otorga a los consumidores ciertos derechos sobre sus datos personales.
En noviembre de 2021, los 193 Estados miembros de la Conferencia General de la UNESCO adoptaron la Recomendación sobre la Ética de la Inteligencia Artificial, el primer instrumento normativo mundial sobre el tema: “no solo protegerá, sino que también promoverá los derechos humanos y la dignidad humana, y será una brújula guía ética y una base normativa global que permitirá construir un sólido respeto por el estado de derecho en el mundo digital”.
Además, algunos países han establecido comisiones y grupos de trabajo para abordar específicamente el impacto ético de la inteligencia artificial, como el Grupo de Expertos en Ética en la Inteligencia Artificial de la Comisión Europea. Es importante tener en cuenta que estos esfuerzos están en constante evolución y aún queda mucho por hacer para garantizar un uso responsable y ético de la inteligencia artificial.
¿Y España?
En nuestro país también se están llevando a cabo medidas regulatorias para abordar los problemas éticos de la inteligencia artificial. En 2020, el Gobierno español presentó la Estrategia Nacional de Inteligencia Artificial, que incluye medidas para fomentar un uso responsable y ético de la inteligencia artificial en el país. Además, se ha creado un grupo de trabajo para desarrollar un marco ético para la inteligencia artificial en España.
Por otro lado, la Agencia Española de Protección de Datos ha publicado una guía sobre el uso responsable de la inteligencia artificial en el ámbito empresarial y está trabajando en la elaboración de directrices específicas para abordar el impacto ético de la inteligencia artificial. En resumen, en España también se están llevando a cabo esfuerzos para abordar los problemas éticos de la inteligencia artificial y garantizar un uso responsable y ético de esta tecnología.
En MIOTI Tech & Business School seguimos de cerca la actualidad informativa sobre la Inteligencia Artificial, así como el marco regulatorio que garantice un uso responsable y ético de la IA, por eso todos nuestros masters, incluyendo los centrados en Inteligencia Artificial como Data Science y Deep Learning, se actualizan constantemente para dar respuesta a las demandas de las empresas siempre respetando los derechos humanos mediante el desarrollo de algoritmos más justos, imparciales y confiables.